

原文链接:The Inner Workings of Distributed Databases
本文作者:Alex Pelagenko;编译:Cointime Freya
本文探讨了流行的时间序列和OLAP数据库用于实现高可用性的各种复制策略。我们从这项研究中得到的启发是,我们将继续在我们以性能为重点的数据库QuestDB中建立复制。该数据库使用C++、低延迟的Java和最近的Rust构建。该代码库没有外部依赖,并使用本地时间序列扩展来实现SQL。
由于我的新电动自行车又一次由于线路问题维修而无法骑去上班,我开始思考如何在我的自行车装备中创建一些冗余,这样我就不会因为简单的维护或供应链问题而在几个星期内都被困在地铁上。如果我有另一辆自行车可以在维修当前的自行车时骑行,这肯定会有帮助,但电动自行车很贵,而且在我的公寓中几乎没有存放备用自行车的空间。
信不信由你,这个问题与我作为数据库开发人员在工作中处理的问题相似。就像自行车一样,数据库也可能会出现故障!有时硬件会神秘地发生故障,或者网络配置发生了变化,导致无法访问您的数据库。当然,您始终可以在故障发生时将数据从备份恢复到新硬件上,但这样你就会被停机和可能丢失的数据所困扰;而且这还是假设你最近测试了你的恢复过程,以确保它能正常工作!即使您能够无缝运行恢复,就像我需要等待店铺完成对我自行车的维修才能再次骑去上班一样,您也需要等待恢复完成并配置新数据库才能使用它。
但是,幸运的是,与我的自行车情况不同,现代数据库有能力在出现故障时保持在线并继续正常运行。这在时间序列数据库的世界中尤为重要,因为它们被设计为不断写入数据,在许多情况下几乎不停歇。没有时间从备份中恢复,因为在任何停机期间都可能丢失宝贵的数据。
这是如何实现的呢?答案是通过复制!通过同步多个数据库节点并构建一个解决方案,当节点故障时将执行移动到正常节点(写入故障转移),数据库可以确保不会丢失任何数据。这就像如果我在通勤途中车胎爆了,可以立即在路中间换到备用自行车一样!听起来很酷,对吧?
在我们开始迈向实现分布式QuestDB的旅程时,我们花时间分析了几个流行的时间序列/OLAP数据库如何实现高可用性,以突显每种方法的优缺点。在回顾基本原理的同时,我们还分享了QuestDB自己的方法和我们对未来的计划。
故障转移
让我们来看看这样一个场景:当一个应用程序向数据库写入数据时,突然出现了网络中断。在这种情况下,应该发生什么?
应用程序应该切换到复制节点并继续插入数据。
例如,如果我有一个应用程序写入到带有副本DB Node 2的DB Node 1中,我可以将此场景绘制为一个序列图:
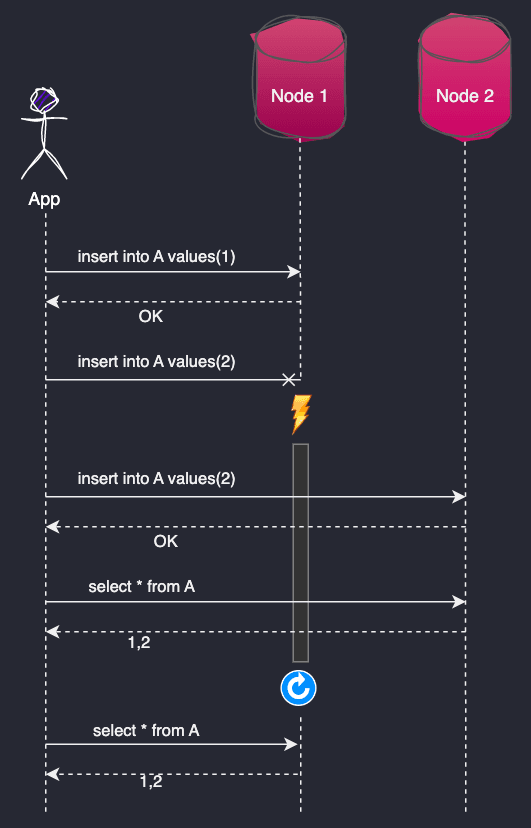
这看起来很简单,但是让数据库在这个过程中发挥作用容易吗?我认为不。为了实现这一点,数据库必须能够通过多个节点将数据写入相同的表A。在一般情况下,数据库还必须演变模式,以支持从多个节点添加/删除列,并在所有副本上按照相同的顺序应用事务。这是因为在应用错误的顺序时,一些事务(如INSERT和UPDATE在同一行上执行)会产生不同的结果。
总之,数据库需要能够:
- 使用多个DB节点将数据写入相同的表(多主机复制),或将数据复制到具有自动故障转移功能的只读复制节点
- 演变表的模式,以便可以从多个连接同时添加相同的表列
- 维护跨副本节点的写入和模式更改的全局顺序
同步和异步复制
当故障发生时,数据库可能会出现不同的问题。例如,数据库节点1在第二次插入insert into A values(2)时无法回复的原因可能有两种:要么节点无法接收和处理事务,要么数据已插入但由于网络断开连接,无法将OK回复传送回应用程序。
为避免在与节点1断开连接后丢失第二个插入操作,应用程序必须将事务insert into A values(2)重复插入到节点2。应用程序还必须在重复insert into A values(2)的尝试中,在节点1已经处理了相同的插入但没有向应用程序传递OK回复的情况下,不创建重复的行。 为了实现这些目标,所有插入到节点1的数据必须能够立即从节点2读取,以便应用程序在失败时执行重复数据删除。或者,必须有另一种内置机制来消除数据库中插入数据的重复项。由此得出的结论是,要实现无间隙、无重复的写入故障转移,必须至少满足以下两点之一:
- 写入到一个节点的数据可以立即通过所有其他副本进行选择,以便写入应用程序可以检查重复项。
- 在插入协议或表存储中内置去重机制。
上述第一条也称为同步 (Sync) 复制,其中节点1仅在插入已经复制到节点2后才会回复OK。相比之下,异步 (Async) 复制允许节点1在将插入的数据复制到节点2之前向应用程序回复OK。这样,节点2可能不会在节点1宕机前收到第一次插入的数据,所以当节点1启动或重新连接时,数据库将不得不重新尝试复制这些数据。
复制方式的选择
回到我的自行车类比,在单个主数据库中配置一个同步模式下的只读副本,就像在一边骑自行车的同时始终试图在另一边推着自行车。你可以想象,同时在两辆自行车上保持平衡是非常困难的,而且几乎不可能骑得很快!
另一方面,在单主节点配置具有只读异步副本的数据库类似于我购买一辆备用自行车,将其存放在工作地点,并在两辆自行车到达同一位置时同步我的行程数据。如果发生故障,我将失去该特定旅程的数据,但我仍然可以在同一天继续骑着备用自行车通勤。
我认为多主复制就像和朋友一起骑两辆双人自行车,每个人都坐在第一个座位上。如果其中一辆双人自行车出现故障,骑手可以移到另一辆自行车的后座上。多主同步复制是两辆双人自行车挨在一起,没有独立转弯或停止的自由。异步复制则是独立骑行,偶尔进行位置/行程数据的同步。
在自行车世界中,异步复制是最合理的选择;我没有看到人们在街上同步骑行自行车。它也是数据库世界中的默认/唯一的选择。同步复制可能很容易理解,并且可能看起来是最好的解决方案,但它需要付出高昂的性能代价,因为每个步骤都需要等待,直到它在每个节点上完成。与此相反的是,即使同步复制使数据同时可用于多个节点,它也会导致集群的可用性降低,因为它大大降低了事务速率。
没有针对写入故障转移问题的万全之策,每个数据库都提供了不同的复制方式以供选择。为了找到QuestDB的最佳选项,我们对其他时间序列数据库中的复制方式如何处理写入故障转移进行了认真的研究,以下是一些结果。
TimescaleDB
每个人都喜欢经典的关系型数据库,几乎每个开发人员都准备回答过有关不同RDMS系统的ACID特性,有时甚至是事务隔离级别的面试问题。使用RDBMS构建分布式读/写应用程序并不容易,但肯定是可行的。
PostgreSQL是领先的开源RDBMS之一,许多人认为它不仅仅是一个数据库。Postgres还是一个可扩展平台,在其中您可以添加地理位置列类型、地理空间SQL查询语法和索引,有效地将其转变为GIS系统。同样,TimescaleDB是PostgreSQL的一个扩展,旨在优化时间序列工作负载的存储和查询性能。
TimescaleDB继承了Postgres的复制功能。PostgreSQL支持多个具有同步或异步复制的只读副本以及所有ACID和事务隔离属性,Timescale也是如此。
不幸的是,PostgreSQL和TimescaleDB都没有解决自动故障转移的问题,但是有一些第三方的解决方案,比如Patroni,增加了对该功能的支持。PostgreSQL将故障转移的过程描述为STONITH(Shoot The Other Node In The Head),意思是一旦主节点开始出现问题,就必须将其关闭。
运行同步复制可以解决故障转移后的数据缺失和重复问题。如果应用程序检测到故障转移,它可以将最后一个未确认的INSERT作为UPSERT重新运行。使用异步复制,升级为主节点的副本上可能会丢失一些最近的事务。这是因为旧的主节点必须被关闭(STONISHed),并且没有简单的方法将缺失的数据从“死亡”的节点移动到故障转移后的新的主节点。
ClickHouse
ClickHouse已经由俄罗斯的搜索供应商Yandex开发了多年的开放源代码。ClickHouse在开源(Apache 2.0)方面的功能非常全面,包括了高可用性和水平扩展。也有相当多的独立托管云提供商支持ClickHouse:
- ClickHouse(Yandex分支)
- Altinity
- Alibaba
在开源产品的背景下谈论ClickHouse的复制很有意义,因为不同的供应商的云功能可能会有很大的不同。
ClickHouse开源的好处是它支持多主机复制。因此,如果创建一个有2个节点(节点1和节点2)的集群,并复制了表A(使用ReplicationMergeTree引擎):
当 Bob 向节点1发送:
INSERT INTO A VALUES(1);
且当 Alice向节点2发送:
INSERT INTO A VALUES(2);
这两条记录将被写入每个节点。当节点1收到INSERT INTO A VALUES(1)语句时,ClickHouse把它写到1_1部分。接下来,节点1将数据部分注册到Zookeeper(或ClickHouse Keeper)。Zookeeper通知每个节点有关新部分的信息,节点从源下载数据并将其应用于本地表副本。同样的过程也同时发生在INSERT 2上。
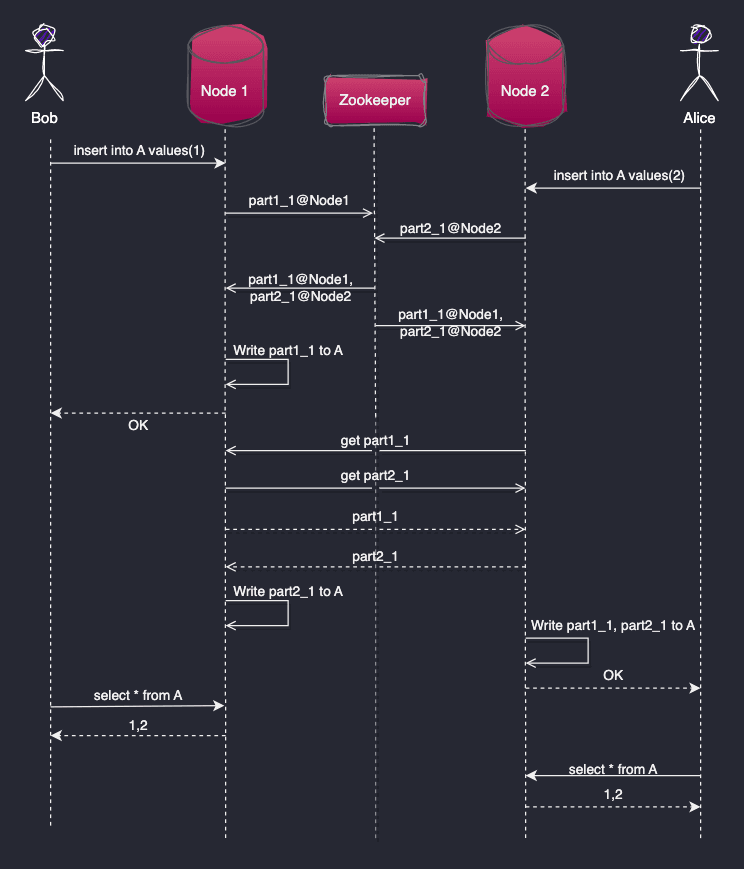
在这种架构中,插入可以并行地写入每个节点。
那么读取数据呢?ClickHouse文档指出,复制过程是异步的,节点2可能需要一些时间来赶上节点1。不过,可以在每次插入时指定insert_quorum。如果insert_quorum设置为2,那么在节点1和节点2都插入数据后,应用程序会从数据库得到确认,有效地将其转换为同步复制。此外还有一些其他设置需要考虑,例如insert_quorum_parallel、insert_quorum_timeout和select_sequential_consistency,以定义并发并行插入的工作方式。
我们还可以通过在复制表上添加新列来修改表的模式。ALTER TABLE语句可以发送到集群中的任何节点,并将在节点之间复制。ClickHouse不允许并发的表模式更改执行,因此如果2个节点收到相同的非冲突语句:
ALTER table A add column if not exists TIMESTAMP datatime64(6)
其中一个节点可以回复失败:
Metadata on replica is not up to date with common metadata in Zookeeper.
It means that this replica still not applied some of previous alters.
Probably too many alters executing concurrently (highly not recommended).
You can retry this error
SQL更新语句在ClickHouse方言中也被写成ALTER TABLE,但幸运的是,它们可以并行执行,而不会出现上述错误。
ClickHouse 还具有解决丢失写入确认的有用方法;在INSERT(或其他)查询确认因为网络断开或超时而丢失的情况下,客户端可以以完全相同的方式将整个数据块重新发送到任何其他可用节点。然后,接收节点会计算数据的哈希代码,如果它能够识别出这个数据已经通过另一个节点应用过,则不会再次应用该数据。
在ClickHouse中有更多关于如何设置复制的选择和风格,其中最流行的方法是ReplicatedMergeTree存储。
InfluxDB
在撰写本文时,InfluxDB拥有最高的DB引擎时间序列排名,尽管InfluxData于2016年将集群产品从开源版本中删除,以将其作为商业产品销售,但我认为它必须包含在此处。从那时起,他们的重点已经从企业版转向了近年来的云服务,在那里他们构建了InfluxDB Cloud v2。虽然这是一个闭源系统,但它的高级架构可以从InfluxData官方提供的营销图中推断出来。
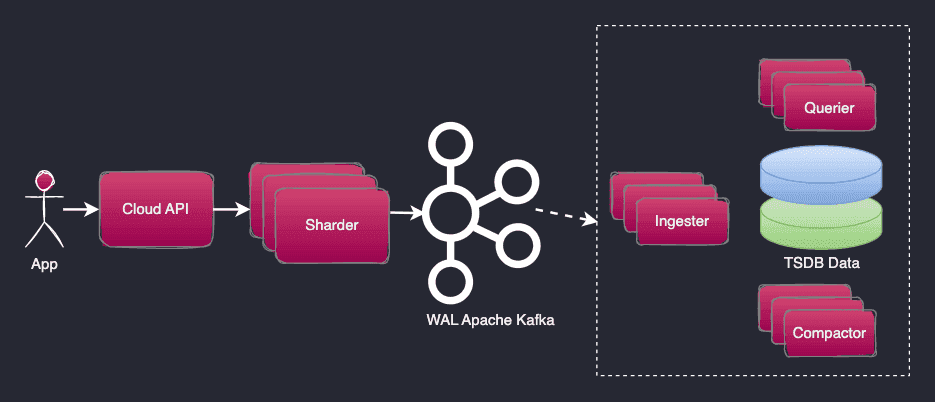
InfluxDB Cloud v2将传入的写入持久化到了在Kafka集群上写入的Write Ahead Log(WAL)中。这是一个利落的解决方案,它解决了WAL的持久性和分布问题,并确保在客户端收到写入确认时已经复制了数据。
WAL应用于 "可查询 "的表存储,在Ingester组件中异步运行,从Kafka销毁消息并将其写入2个独立的TSDB副本。在确认写入的消息被读取之间存在延迟,这在InfluxDB中被称为Time to Become Readable。
Influx协议消息是幂等的,这意味着同一消息可以被处理多次而不会创建重复项。这是因为在InfluxDB中,同一组标签的每个时间戳值只能有一条记录。因此,如果一个人发送了一行:
measurement1 field=34.23 1562387656300000000
然后发送另一行相同的测量值和时间戳:
measurement1 new_fields=0.1234 1562387656300000000
新的字段值将被添加到同一行中,就好像这些字段在同一消息中一起被发送:
measurement1 field=34.23,new_fields=0.1234 1562387656300000000
而如果再次发送上述任何一条消息,Influx将不会添加新的行。这种方法解决了超时或丢失回复时重新发送数据的问题。因此,如果客户端没有从Influx Cloud接收到写入确认,它可以一遍又一遍地重新发送相同的数据。当数据以相同的时间戳和标签集从不同的连接发送时:
measurement1 field1=1 1677851990000000000
measurement1 field1=2,field2=2000 1677851990000000000
查询的存储节点可能会在一段时间内变得不一致,返回3条中的任何一条:
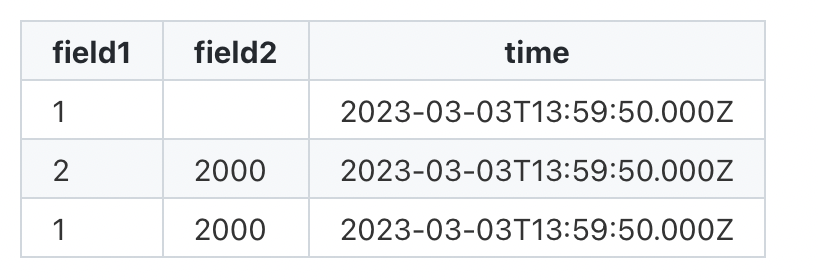
有时甚至会第一次查询返回 field1=1,第二次查询返回field1=2,然后第三次查询尝试切换回field1=1。最终,查询结果将变得稳定,并在每次运行时返回相同的数据。这是使用异步复制的Round Robin查询节点的一个非常典型的结果。
Influx数据模型还解决了动态演化模式的问题。由于没有传统的列(因为数据库引擎会自动添加遇到的任何未知字段和标签),因此为设计的相同度量编写不同的字段集是没有问题的。Influx还会检查模式冲突,并在有冲突时向写入应用程序返回错误。例如,如果将同一字段作为数字和字符串发送:
m1 value=34.23 1562387656300000000
m1 value="hello" 1562387656300000123
写入将失败,并返回错误column value is type f64 but write has type string 或 column value is type string but write has type f64。
总结
以下是与高可用性写入用例相关的,时间序列数据库支持的复制功能的总结:
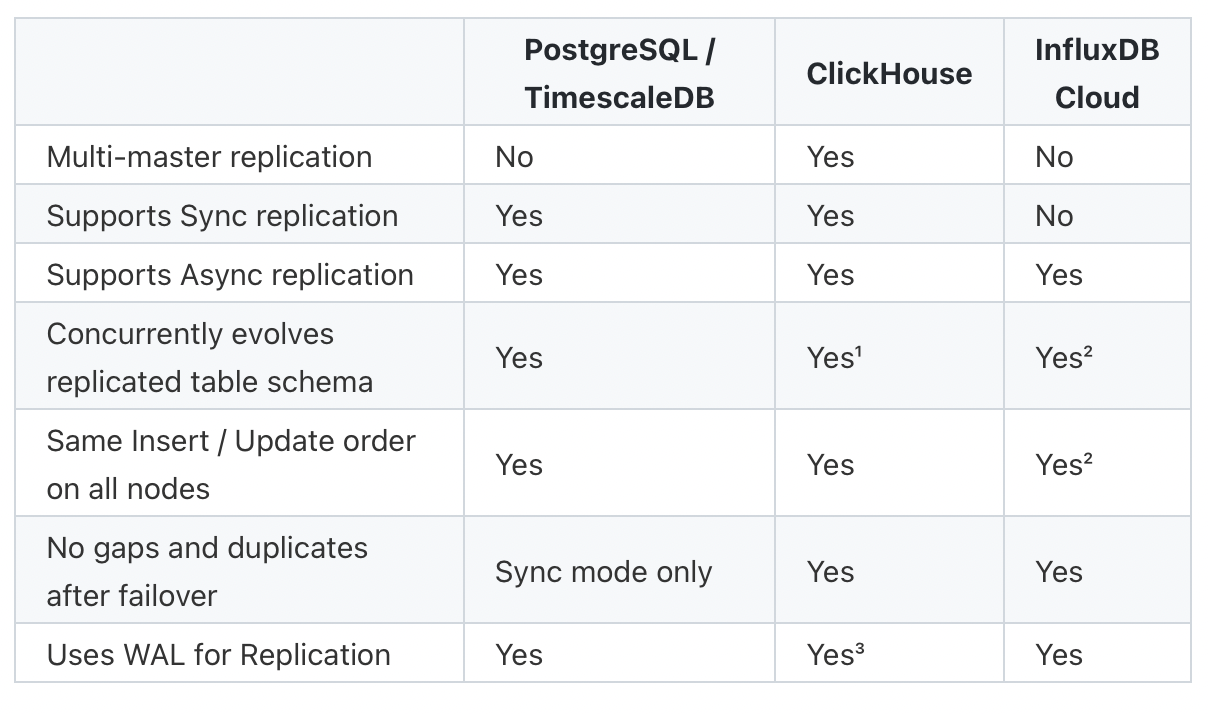
1. 并发模式更新必须重新尝试。
2. InfluxDB Cloud是一个闭源系统,某些结论是在合理使用Kafka WAL分区的假设基础上得出的,这个结论的正确性取决于实现。
3. ClickHouse复制的Data Part起到了WAL的作用。
由此我们得出了一些结论:
- 所有三个系统都通过写入Write Ahead Log并在节点之间复制来进行复制。
- 异步复制(写入节点1的数据最终在节点2上可见)是InfluxDB Cloud最常用的方法,也是ClickHouse和Postgres的默认方法。
- Postgres / Timescale复制可以在同步和异步模式下使用,但它没有多主复制,并且没有自动故障转移选项。如果没有额外的软件系统或人工干预,是不可能解决写入故障转移的。
- ClickHouse中可以使用多主复制。还有足够的可用设置,可以在数据丢失(在极端情况下)和写入吞吐量之间取得适当的平衡。
- InfluxDB在其开源产品中不提供复制支持。有一个闭源的云解决方案,利用Kafka来解决自动写入故障转移。Kafka复制不是多主的,但在自动故障转移的帮助下,它解决了高可用性的写入用例。
QuestDB复制计划
QuestDB在v7.0中发布了Write Ahead Log表存储模式,这是我们复制之旅的第一步。它在内部使用了多主写入架构,使得通过并行连接对同一表进行非锁定写入操作成为可能。事务被并行地写入不同的WAL段,全局的提交顺序由Sequencer组件来维护。其最复杂的部分是自动解决模式冲突,以便表模式的更改也可以并行执行。
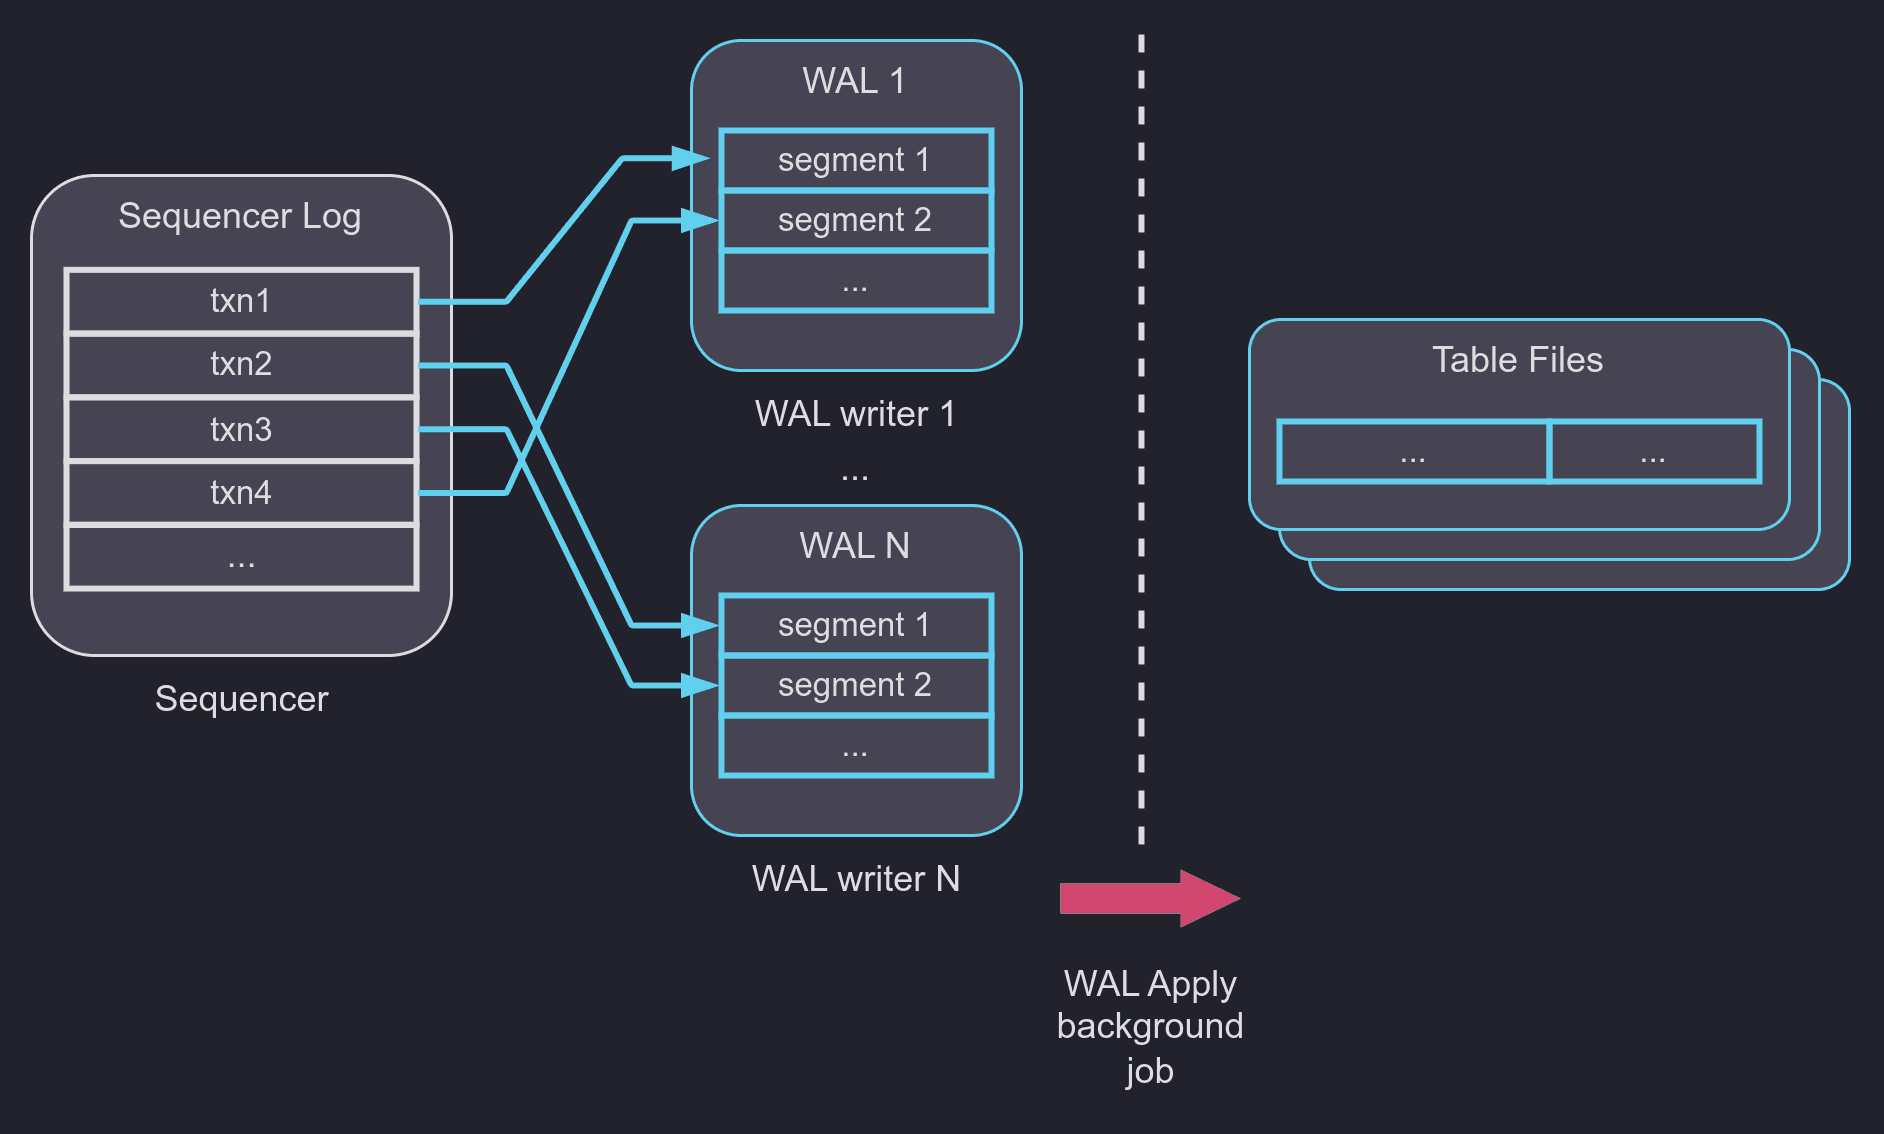
在很长一段时间里,我们试图避免使用Write Ahead Log,直接写入表的存储中。为了更清晰地实现复制和非锁定并行写入,接受WAL的写入强化不是一个容易的决定。最终,额外的写入操作没有影响总吞吐量。相反,由于更好的并行性,我们在Time Series Benchmarking Suite中取得了比我们自己的非WAL表的性能(非常出色)好3倍的写入性能。
考虑到其他数据库如何解决复制问题,我们选择了以实现具有异步一致性的多主复制为目标。我们认为这种方法在容错性和事务吞吐量之间取得了最佳平衡。在自动写入故障转移的情况下,拥有内置的写入去重机制是必不可少的。QuestDB的下一步是将内置的Sequencer组件移动到分布式环境中,并解决多个实例之间的WAL共享问题。
和朋友一起骑双人自行车是我们为QuestDB提供的最好的冗余解决方案。至于我的通勤问题,我仍然不知道该如何解决。欢迎加入我们的Slack社区并分享您的反馈。您也可以体验 QuestDB的在线演示或通过play.questdb.io来看看它运行得有多快。
*本文由CoinTime整理编译,转载请注明来源。

所有评论